DeepSeek Harness — что это, зачем нужен и как настроить с шлюзом LiteAI
Объяснение, зачем вокруг DeepSeek нужен harness (обвязка): агентный цикл, tool calling, стриминг, ретраи и учёт токенов. Пошаговая настройка с шлюзом LiteAI: OpenAI-совместимый эндпоинт api.liteai.tech/v1, ключ sk-bf-…, выбор модели, тест-запрос curl и пример конфига. Скриншот с примером настроек.
DeepSeek Harness — что это, зачем нужен и как настроить с шлюзом LiteAI
DeepSeek — серия моделей с нативным tool calling: дешёвые, с длинным контекстом и предсказуемым JSON-ответом. Именно поэтому на них чаще всего собирают автономных агентов. Но сама модель — лишь «мозг». Чтобы превратить его в рабочего инструмента, нужна обвязка, которую в сообществе так и называют — harness.
Что такое DeepSeek Harness простыми словами
Harness — тонкий слой кода вокруг вызова модели. Он не меняет саму модель, а делает её пригодной для реального использования:
- Агентный цикл — «подумал → вызвал инструмент → получил результат → подумал снова» до тех пор, пока задача не решена.
- Tool calling — разбор
tool_callsиз ответа, вызов нужной функции (поиск, bash, редактор, браузер), передача результата обратно модели. - Стриминг и прогресс — частичные ответы по SSE, видимость того, что агент делает прямо сейчас.
- Ретраи и лимиты — обработка 429/5xx с exponential backoff, max-итераций, budget-кап на сессию.
- Учёт токенов —
usageна каждый запрос, стоимость сессии, лимиты по времени и деньгам.
Зачем это всё? Попробуйте затащить «голый» client.chat.completions.create() в петлю и получите три классические боли:
- Лимиты и ошибки. DeepSeek (как и любой провайдер) отдаёт 429 при превышении RPS/TPM. Без ретраев и backoff агент падает посреди задачи.
- Длина контекста. Агент быстро накопит историю «подумал → вызвал → получил». Без обрезки/сжатия истории вы упрётесь в потолок контекста.
- Циклы и бесконечность. Модель может зациклиться: вызывать один и тот же инструмент, повторять шаги. Нужны max-итерации и стоп-условия.
Harness — стандартная практика. Каждый популярный CLI/фреймворк для агентов — по сути harness: Claude Code, OpenCode, Codex CLI, Aider, Droid и десятки библиотек. С DeepSeek вы просто подменяете «движок»: тот же цикл и инструменты, но модель отвечает через DeepSeek — с заметной экономией на token-цены.
Настройка: DeepSeek Harness через шлюз LiteAI
Теперь практичная часть: как подключить DeepSeek через наш шлюз LiteAI. Идея простая: вы подменяете базовый URL и API-ключ своего harness'а (или любого OpenAI-совместимого клиента) на наши — а саму конфигурацию harness'а (модели, temperature, max iterations, tools) оставляете своей. На скриншоте ниже — заполнение настроек кастомного провайдера liteai.tech в клиенте: имя провайдера, base URL шлюза и ваш API-ключ:
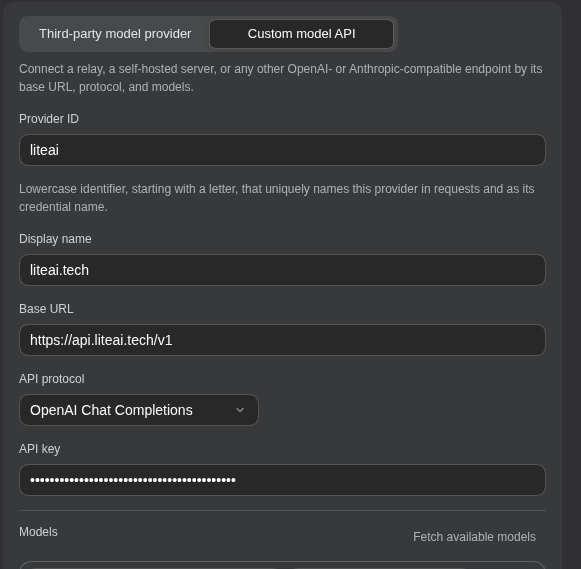
Получите ключ LiteAI. На странице /pricing купите пакет токенов (от 30 ₽ за 1M) — после оплаты на вашу почту придёт ключ вида
sk-bf-….Проверьте, что DeepSeek доступен у вас. Открытый список моделей зависит от текущего каталога, поэтому самый быстрый способ убедиться — запросить его напрямую:
curl https://api.liteai.tech/v1/models \
  -H "Authorization: Bearer sk-bf-..." \
  | jq '.data[].id'
Если в выдаче есть DeepSeek — фиксируйте точное имя модели (
deepseek-chatдля V3-серии,deepseek-reasonerдля R1, либо другой вариант, если ваш каталог использует иные имена) и подставляйте его в конфиг harness'а. Не видите DeepSeek — уточните актуальный каталог в документации или попросите нас добавить нужную модель в ваш план.Выдайте доступ в harness. Задайте в окружении или конфиге вашего инструмента:
- Base URL:
https://api.liteai.tech/v1; - API Key:
sk-bf-…; - Model: имя из шага 2.
- Base URL:
Запустите smoke-тест. Проверьте соединение минимальным запросом:
curl https://api.liteai.tech/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-bf-..." \
  -d '{
    "model": "deepseek-chat",
    "messages": [{"role": "user", "content": "Answer in one word: hi"}],
    "max_tokens": 10
  }'
В ответе должны прийти
choices[0].message.contentи блокusageсо счётчиком потраченных токенов.Проверьте tool calling. Отправьте запрос с декларацией инструментов и убедитесь, что модель возвращает корректный JSON в
tool_calls— именно на этом держится агентный цикл:curl https://api.liteai.tech/v1/chat/completions \ -H "Content-Type: application/json" \ -H "Authorization: Bearer sk-bf-..." \ -d '{ "model": "deepseek-chat", "messages": [{"role": "user", "content": "What is the weather in Moscow?"}], "tools": [{ "type": "function", "function": { "name": "get_weather", "description": "Get current weather for a city", "parameters": { "type": "object", "properties": {"city": {"type": "string"}}, "required": ["city"] } }] }'Соберите конфиг. Минимальный рабочий пример конфига harness'а, привязанного к шлюзу LiteAI:
{
  "provider": "openai-compatible",
  "base_url": "https://api.liteai.tech/v1",
  "api_key": "sk-bf-...",
  "model": "deepseek-chat",
  "temperature": 0.3,
  "max_steps": 25,
  "max_history_turns": 20,
  "timeout_seconds": 60,
  "max_retries": 3
}
Два параметра напрямую лечат боли «голого» API:
max_stepsспасает от зацикливания (агент сам остановится после 25 итераций),max_retries: 3— от 429 (ретрай с backoff уже встроен в большинство harness'ов).
Пара слов про выбор модели. Для чистых tool-calling агентов берите deepseek-chat — V3-серия отвечает быстрее и стабильнее в генерации JSON. deepseek-reasoner (R1) берите, когда важно качество рассуждений: математика, логика, сложные multi-step задачи. Подробнее — в статье про free-tier DeepSeek на OpenRouter.
Частые вопросы
Нужен ли отдельный аккаунт DeepSeek?
Нет. Весь путь «запрос → ответ → токены» идёт через наш шлюз: вы говорите с LiteAI, LiteAI говорит с DeepSeek. Ваш sk-bf-… — единственная секретность во всей цепочке.
Почему не подключить DeepSeek напрямую (api.deepseek.com)? Можно, и для многих сценариев прямой путь быстрее. Шлюз LiteAI оправдывает себя, когда вам нужно одно из: оплата в рублях (карта РФ или СБП, без иностранного BIN), единый ключ для нескольких моделей в одном аккаунте (Claude + GPT + DeepSeek), или отсутствие VPN. Если прямой путь вам подходит — берите его; если нужен один ключ на всё — через LiteAI.
Стриминг работает?
Да, SSE-стриминг поддержан в OpenAI-совместимом формате. Если ваш harness ожидает stream: true и получает data: {...} события — он уже совместим, достаточно поменять base URL.
Как считать стоимость сессии?
Каждый ответ содержит блок usage (prompt_tokens, completion_tokens, total_tokens). Сложите total_tokens по всем запросам в сессии и умножьте на текущую цену за 1M токенов для вашей модели — это и есть полная стоимость. Большинство harness'ов делают это автоматически, вы увидите итог в конце сессии.
Что делать, если пришёл 429?
Это превышение rate-limit: у вас RPS выше разрешённого или TPM (токенов в минуту) накопилось. Правильная реакция уже заложена в max_retries: 3: харнec делает exponential backoff (1s, 2s, 4s) и пробует ещё раз. Если 429 возвращается подряд несколько раз подряд и retries уже исчерпались — подождите 30–60 секунд и продолжайте. Полный каталог кодов и причин — в статье про ошибки Claude API, там та же логика применима и к нашим эндпоинтам.
Поддерживается ли prompt caching?
Да, в формате Anthropic-style cache (cache_control маркеры), если ваша модель поддерживает. Для DeepSeek через OpenAI-совместимый эндпоинт кешуется системный промпт автоматически.
Сколько я трачу на типичную сессию? Для обычного code-agent сессии с 50–100 итерациями: 200–500K токенов суммарно. Это 6–15 ₽ по нашей цене 30 ₽/1M. Полная 30-минутная сессия — примерно 2–4 рубля. Если нужно дешевле — смотрите, что реально бесплатное; если нужно дороже и мощнее — берите пакет от 10M.
Что будет, если закончатся токены? Придёт 429 с detail «insufficient balance» (или аналогичное). Пополните пакет на /pricing и продолжайте — история и настройки harness'а сохранятся, ничего пере-настраивать не нужно.
Итог
DeepSeek Harness — это не «ещё одна модель», а стандартный способ превратить дешёвую модель в работающего агента: тот же цикл tool calling, стриминг, ретраи, учёт токенов. Разница только в том, куда ходят запросы: напрямую в api.deepseek.com (если вам нужен просто дешёвый инференс) или через наш шлюз LiteAI (если нужна оплата в рублях, один ключ на все модели, или отсутствие VPN).
Если вы ещё не определились с моделью и провайдером — начните с сравнения Claude / GPT / DeepSeek. Хочется попробовать DeepSeek вообще бесплатно — смотрите статью про free-модели OpenRouter. А если хочется сэкономить на token-расходах в любом harness'е — читайте про rtk, CodeGraph и точный контекст.
Готовы попробовать LiteAI?
API ключ для 18 AI-моделей — Claude, GPT, DeepSeek, Qwen — за 30 секунд, оплата в рублях.